三个月,一场必然失败的Tokenmaxxing
三个月,一场必然失败的Tokenmaxxing早在3月20日,纽约时报的凯文·罗斯就发现了在硅谷开发者中,出现了一种叫做 Tokenmaxxing的现象。这个现象最早出现在OpenAI、Anthropic等前沿模型开发公司。OpenAI 的工程师一周用了 2100 亿个token,大概是 33 个维基百科的量;Claude Code 的工程师则一个月单人可以烧15万美元token。
搜索
早在3月20日,纽约时报的凯文·罗斯就发现了在硅谷开发者中,出现了一种叫做 Tokenmaxxing的现象。这个现象最早出现在OpenAI、Anthropic等前沿模型开发公司。OpenAI 的工程师一周用了 2100 亿个token,大概是 33 个维基百科的量;Claude Code 的工程师则一个月单人可以烧15万美元token。
Minerva 正式公开上线了他们的 AI 营销平台,同时宣布完成了这轮融资。投资方名单相当亮眼:The General Partnership、8VC、Lingotto Innovation、Topology Ventures,还有 NBA 官方投资部门 NBA Investments。与此同时,他们还公布了与 OpenAI 的深度合作关系,
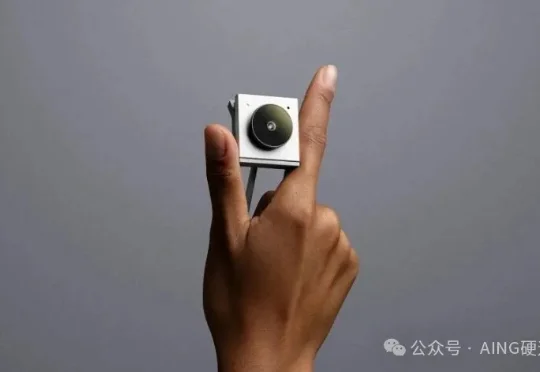
主打高端直播 / 会议高清摄像头的Opal Camera在卖了超 5 万台设备后2025 年正式更名 Opal Electronics(以下简称Opal ),转型全品类 AI 消费硬件。随后OpenAI 领投4000 万美元,投资方含三星、Peter Thiel 基金、MKBHD(知名数码博主),投后估值2.75 亿美元。
本周「十字路口」,我们聊 FDE 这个正在被重新定义的岗位与分工:它究竟是在把“售前/交付”换个名字,还是代表 ToB AI 时代新的组织结构与商业边界?当模型越来越强,最后一公里为什么依然最难?企业真正缺的,到底是更强的模型,还是能把 AI 带进流程、接入系统、治理知识、持续迭代并对结果负责的人?
继本月初 Anthropic 之后,OpenAI 也秘密提交了首次公开募股(IPO)申请。
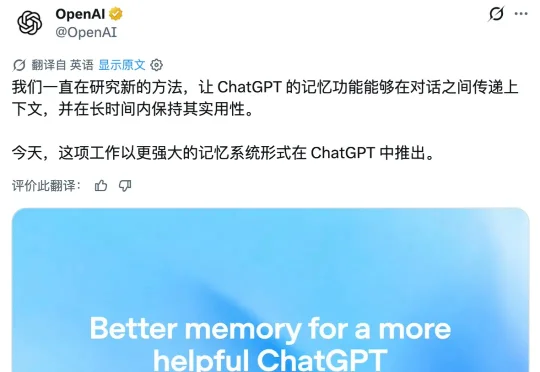
今天起,ChatGPT 的记忆系统更像人了。OpenAI 刚刚推出了一套全新的记忆系统,底层基于 Dreaming 技术。它会在长期对话中自动整理你的偏好、项目、设备、旅行计划和生活安排,并在回答时判断哪些信息仍然有用,哪些已经过时。
几天前,OpenAI 用 AI 模型解决了一个关于点与点之间距离的数学问题,此前 80 年来这道题目一直未被完全攻克,消息一出一度被媒体刷屏。不过,没隔几天 16 位数学家站了出来,他们在荷兰莱顿大学发布了一份名为《莱顿宣言》的文件 [1]。
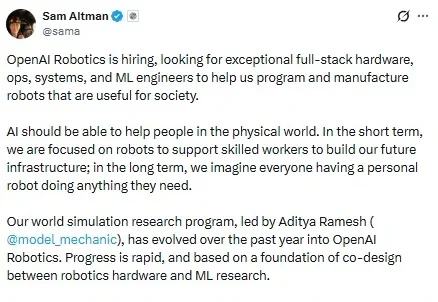
“OpenAI 进军机器人领域!”
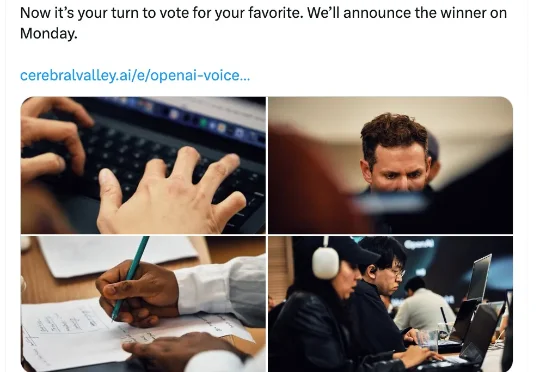
OpenAI 公布了他们语音黑客松的四个入围项目,目前正在公开投票。 四个入围项目 这是 OpenAI 和 Cerebral Valley 在旧金山联合办的一场黑客松。5 月 27 日,在 OpenAI 总部,参与者带着自己的语音 Agent 原型到现场展示。
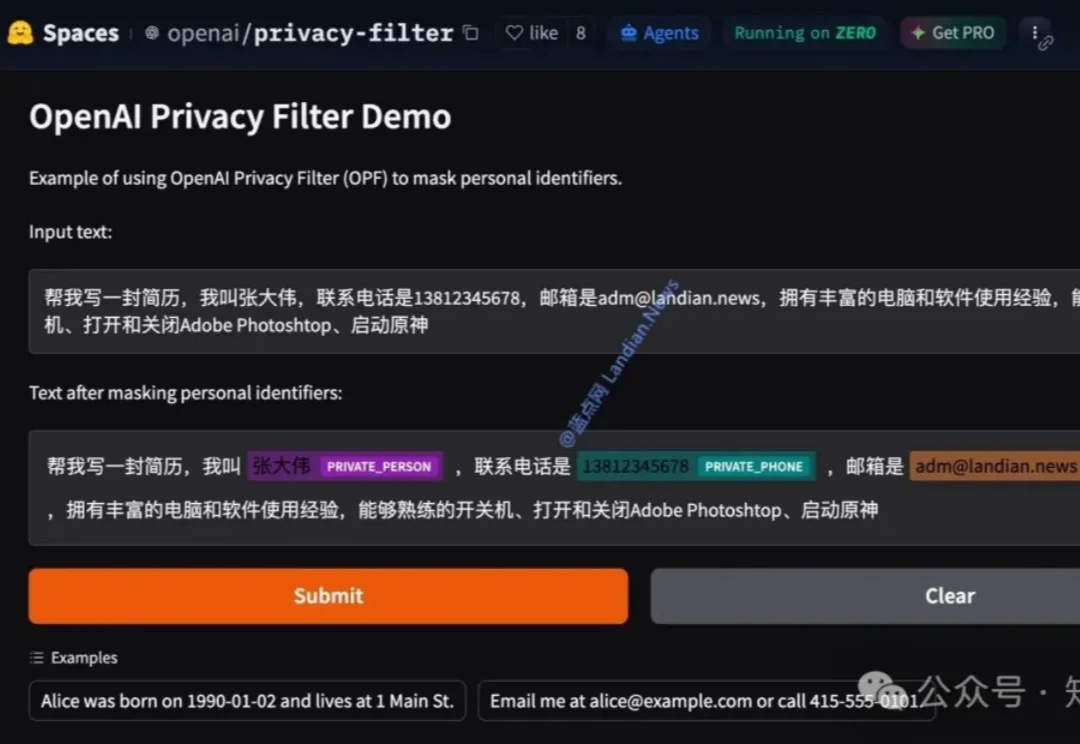
你有没有过这样的经历:把聊天记录、用户反馈或内部文档丢给大模型时,总担心里面夹杂着真实姓名、手机号、邮箱甚至 API key,最后只能手动一条条删?或者团队在处理海量数据时,规则写的正则永远漏掉那些“藏在句子里的隐私”。